Lokalny model kodujący na RTX 4060. Co zmierzyliśmy i gdzie się rozsypał
Ollama, Aider i dwa modele Qwen na karcie z 8 GB VRAM. Twarde liczby, obalona hipoteza o MoE i trzy reguły pisania instrukcji, które wyszły z pomiaru.
Pytanie wraca na każdym wdrożeniu u klienta z działem IT: czy da się postawić agenta kodującego lokalnie, żeby kod nie wychodził z firmy. Odpowiedź “to zależy” jest bezużyteczna, więc spędziliśmy dzień na mierzeniu. Poniżej liczby, jedna obalona hipoteza i trzy reguły, które wyszły z pomiaru, a nie z przeczucia.
Sprzęt celowo konsumencki: Ryzen 7 5700X, 31 GB RAM widocznego w WSL, RTX 4060 z 8 GB VRAM.
Stos: Ollama 0.33.1 zainstalowana rootless, Aider 0.86.2, dwa modele - qwen2.5-coder:7b
w kwantyzacji Q4_K_M (4,7 GB) i qwen3-coder:30b, czyli MoE ze 128 ekspertami, z których liczy
się 8 naraz (18 GB).
Najpierw sterownik, bo bez niego nie ma o czym rozmawiać
Ollama nie widziała karty. Diagnoza warstwa po warstwie: cuInit i runtime CUDA 12.8 rozpoznawały
GPU poprawnie, ale ggml_cuda_init zwracał device kernel image is invalid. Powód okazał się
prozaiczny i wart zapamiętania: fatbin w cuda_v12 zawierał kernele wyłącznie dla architektur
sm_100 i sm_120, a sterownik z lipca 2023 (driver API 12.2) nie potrafi zJITować PTX-a
wygenerowanego przez nowszą CUDĘ. Kompatybilność JIT-a nie działa w przód. Vulkan też odpadał,
bo w WSL nie ma ICD NVIDII.
Po aktualizacji sterownika (CUDA UMD 13.4) Ollama od razu załadowała cuda_v13. Jeśli
diagnozujesz podobny objaw, sprawdź wersję driver API, zanim zaczniesz podejrzewać model albo
kwantyzację.
Liczby
Baseline na samym CPU: 5,6 tokena na sekundę generacji, 29 tokenów na sekundę przetwarzania promptu.
| qwen2.5-coder:7b | qwen3-coder:30b (MoE) | |
|---|---|---|
| Rozmieszczenie wag | 29/29 warstw na GPU, 4168 MiB | atencja na GPU (2651 MiB), 15 756 MiB ekspertów w RAM |
| Generacja, krótki kontekst | 52-53 tok/s | 19 tok/s |
| Prompt, 22,5 tys. tokenów | 1758 tok/s, 12,8 s | 206 tok/s, 108,8 s |
| Deklarowany max kontekst | 32 768 | 262 144 |
Przyspieszenie 7B względem CPU: generacja 9,5x, przetwarzanie promptu 60x.
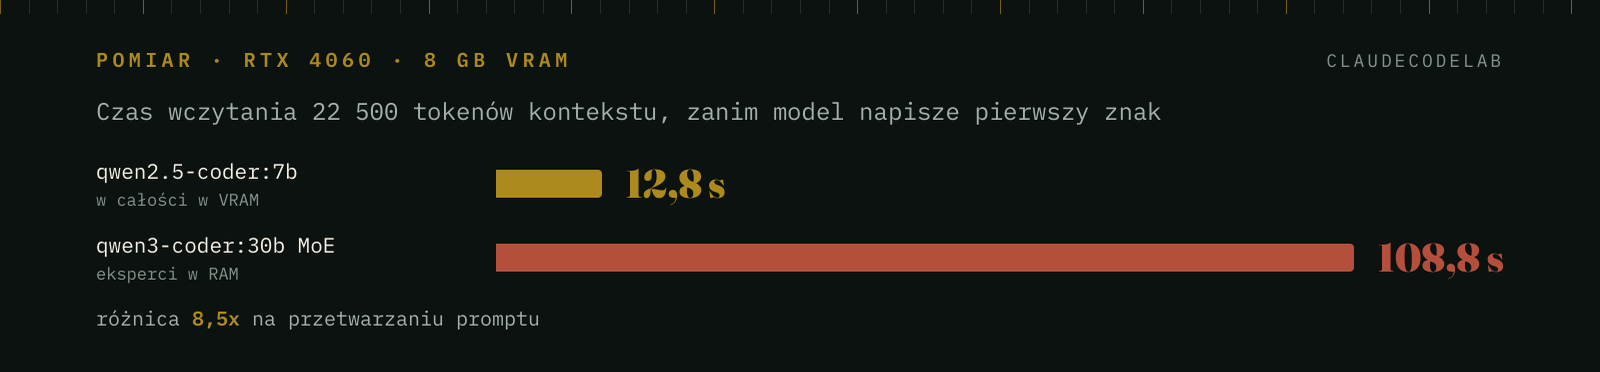
Ta jedna różnica, 12,8 sekundy kontra 108,8 sekundy na wczytanie tego samego kontekstu, przesądza o wyborze modelu bardziej niż cokolwiek innego w tej tabeli.
Hipoteza, która się nie obroniła
Przed testem zakładaliśmy, że na 8 GB VRAM właściwym kandydatem jest model MoE. Logika brzmiała sensownie: 30 miliardów parametrów wiedzy, około 3 miliardy liczone naraz, eksperci mieszkają w RAM-ie, w VRAM zostaje atencja i KV cache. Dużo modelu za mało pamięci.
Pomiar to odwrócił. Eksperci w RAM-ie oznaczają, że każdy token promptu przeciąga wagi przez PCIe. Przy 22,5 tys. tokenów kontekstu 30B potrzebuje 109 sekund samego czytania, zanim napisze pierwszy znak. 7B, który mieści się w VRAM w całości razem z KV cache, robi to w 13 sekund.
To jest różnica, która decyduje, bo agent kodujący żyje promptem, nie generacją. Czyta kontekst przy każdej turze, a wypluwa kilkaset tokenów diffa. Optymalizowanie generacji w tym scenariuszu to optymalizowanie niewłaściwej rzeczy.
Strojenie, które warto zostawić na stałe
Dwie zmienne środowiskowe zbijają KV cache modelu 7B z 1792 do 952 MiB:
OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serveDzięki temu ostatnia warstwa wraca z CPU na GPU (29/29 zamiast 28/29), a generacja przy pełnym 32k kontekście rośnie z 25 do 38 tokenów na sekundę. Jakość odpowiedzi na teście zrozumienia kodu bez zmian.
Pułapka: prompt ucinany po cichu
Przy prompcie większym niż okno Ollama nie zwraca błędu. Zostawia połowę:
WARN msg="truncating input prompt" limit=16386 prompt=67240 keep=4 new=16386Model dostaje 16 tys. tokenów zamiast 67 tys. i odpowiada tak, jakby widział całość. Dla agenta to cichy błąd najgorszego rodzaju, bo wygląda jak poprawna odpowiedź.
Sufit 7B to 32 768 tokenów i jest to limit modelu, nie VRAM-u. Podnoszenie num_ctx do 65536 nie
daje nic. Bezpiecznie przeszło 28 044 tokeny bez obcięcia. Aider dodatkowo potrzebuje pliku
.aider.model.settings.yml w katalogu projektu, bo domyślnie jedzie na 8k i po cichu przycina
repo mapę:
- name: ollama_chat/qwen2.5-coder:7b
  edit_format: diff
  use_repo_map: true
  extra_params:
    num_ctx: 32768
Test pierwszy: realne zadanie z testami
Zadanie na aplikacji Next.js z 30 testami w vitest: dopisać funkcję formatującą NIP i testy do
niej. Weryfikacja obiektywna, npm test.
7B: 32 na 32 testy w 47 sekund. Pierwsza wersja nie dopisała importu, --auto-test to wyłapał,
druga runda przeszła. 30B: 32 na 32 w 94 sekundy, za pierwszym podejściem, z lepszym pokryciem
przypadków brzegowych.
Oba modele poprawnie posługują się formatem SEARCH/REPLACE Aidera i trafiają w istniejący kod. Na tym poziomie zadania lokalny model jest po prostu użyteczny.
Test drugi: to samo bez sprawdzianu
Drugie zadanie: zbudować i poprawiać landing page. Pięć rund z poleceniem “popraw, sam zdecyduj, co jest najsłabsze”.
7B przez pięć rund i 219 sekund nie naprawił ani jednego z dwóch realnych defektów: trzynastu tekstów zastępczych i brakującej reguły CSS, przez którą trzy karty stały jedna pod drugą zamiast obok siebie. Runda czwarta dała zero zmienionych linii - model przepisał identyczną treść i zakomunikował, że stronę ulepszył. 30B nasycił się po dwóch rundach i przez kolejne 693 sekundy nie wyprodukował nic, a przy okazji zjechał z wymaganego nagłówka na własny, z błędem gramatycznym, którego już nie cofnął.
Potem to samo zadanie z instrukcjami wskazującymi konkretny defekt, z tego samego punktu startowego:
| 5 rund generycznych | 5 rund kierowanych | |
|---|---|---|
| qwen2.5-coder:7b | 219 s, zero napraw | 154 s, treść + układ + paleta + ceny + CTA |
| qwen3-coder:30b | 1147 s, dryf od briefu | 662 s, wszystko w zadanym zakresie |
Rundy kierowane były szybsze i skuteczniejsze naraz, bo model generuje wtedy dużo mniej: 810 tokenów zamiast 1700. Nie przepisuje całego pliku na wszelki wypadek. Brakującą regułę CSS, której nie zauważył przez pięć rund, 7B naprawił w 23 sekundy po wskazaniu jej wprost.
Trzy reguły, które wyszły z pomiaru
Kotwicz instrukcję o selektor, nie o numer linii. W ostatniej rundzie wskazaliśmy 7B sześć wystąpień koloru wpisanego na sztywno, każde z numerem linii. Naprawił dokładnie te trzy, przy których podaliśmy także nazwę selektora. Nie tknął tych trzech opisanych samym numerem linii. Korelacja trzy na trzy. Model nie liczy linii, szuka kotwicy w tekście, więc podawaj mu nazwę funkcji, selektor albo dosłowny ciąg znaków.
Wyliczaj, nie każ przeszukiwać. Ten sam model dostał dwa polecenia naraz: “podmień te osiem zmiennych” wykonał co do znaku, “przejrzyj cały plik i zamień każdy kolor wpisany na sztywno” zignorował, zostawiając sześć wystąpień. 30B na tym samym zadaniu zszedł z trzynastu do dwóch. Przeszukiwanie skaluje się z wielkością modelu, wyliczanie nie.
Pisz zakres wprost. “Nie zmieniaj index.html” oba modele respektują i generują wtedy o połowę mniej tokenów, więc runda jest szybsza. Bez tego przepisują wszystko i dryfują od specyfikacji.
Wniosek
Granica użyteczności lokalnego modelu nie przebiega między 7B a 30B. Przebiega między “jest obiektywny sprawdzian” a “nie ma”.
Ten sam model, ta sama godzina: z npm test zdał w 47 sekund, bez sprawdzianu kręcił się pięć rund
w przekonaniu, że ulepsza. To nie jest wada konkretnej wagi, tylko strukturalna cecha: model nie ma
dostępu do własnej porażki. Potrafi wykonać, nie potrafi ocenić.
Praktycznie oznacza to, że lokalny model wpina się w proces tam, gdzie już masz sygnał zwrotny: testy, linter, typy, walidacja schematu, kompilator. W tych miejscach 7B na karcie za 1500 złotych robi robotę w kilkadziesiąt sekund, za darmo i bez wysyłania kodu na zewnątrz. Tam, gdzie “dobrze” znaczy “ktoś to ocenił”, lokalny model nie zastąpi ani człowieka, ani modelu z chmury.
Jeśli zastanawiacie się, które fragmenty waszego procesu mają taki sprawdzian, a które tylko wyglądają, jakby miały, to jest dokładnie ta rozmowa, którą prowadzimy na wdrożeniach: 30 minut, bez zobowiązań.
Podobał Ci się ten artykuł?
Udostępnij go osobom, którym ten materiał może się przydać.